 WALKSCAPE
 Crosswave Edition
生成AIはどう学ぶのか。Google Cloudの入門講座から
2025-12-28
Google Cloudの入門講座で学べること
ChatGPTなどが登場し、生成AIは短い間に日々の仕事に入ってきた。多くの人にとって、 文章の下書き、イラスト、コードを書き始める方法が変わった。
技術各社は、日ごろ使う製品に生成モデルを組み込んでいる。ソフトウェアの動き方がどう変わったのかと、個々の新機能が何を約束しているかは、混同しやすい。
製品を問わずに当てはまる問いから始めたい。
「今まで一度も頼まれたことのないものを、システムはどう学んで作れるようになるのか」
四つの問いから始める入門
手がかりになるのが、Google Cloudの Coursera講座「Introduction to Generative AI」だ。
講座ページでは、動画は約24分、ほかの課題も含めて約1時間と案内されている。数式や実装へ進む前に、 初めて学ぶ人が全体像をつかむ ための講座だ。
主な問いは四つある。
- 生成AIとは何か。
- どのように動くのか。
- どんな種類の生成モデルがあるか。
- 何に使えるか。
生成モデルが作れるもの
講座は、システムが何を出力するかから説明する。
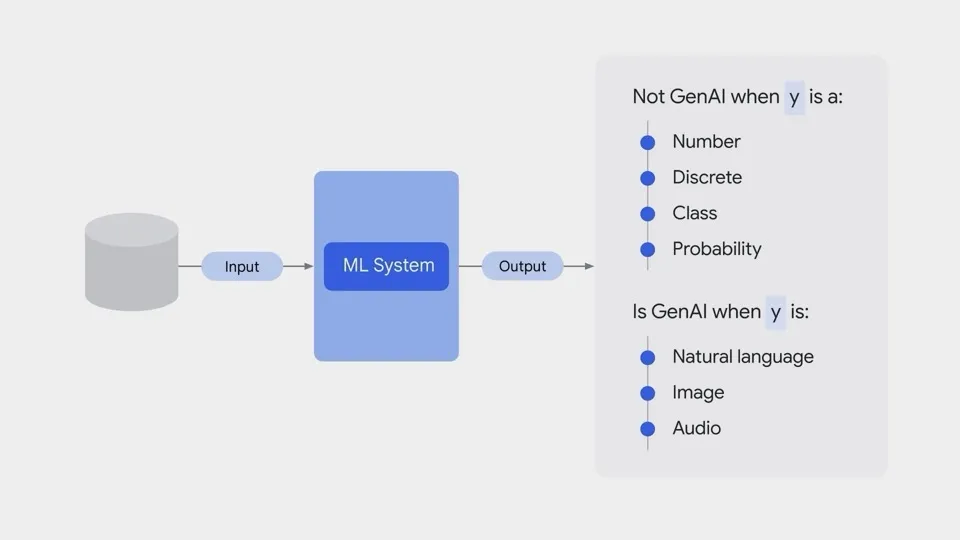
生成システムは、与えられた入力に応じて 文章、画像、音声、動画、合成データ などを作れる。
迷惑メールを見分けるモデルや需要を予測するモデルは、分類結果や数値を出すことがある。生成システムは、文章の段落や画像のように、 よりまとまりのある出力を少しずつ組み立てることができる。大規模言語モデルは、その代表例のひとつだ。
AI、機械学習、深層学習
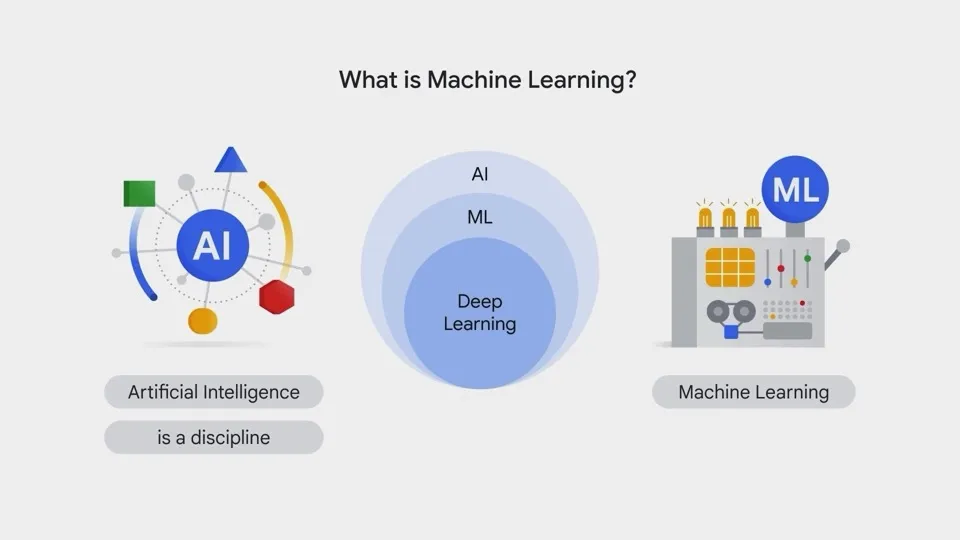
講座では、混同されやすい三つの言葉をまず分けて考える。
関係を並べると、 AI → 機械学習 → 深層学習の順に範囲が狭くなる。
- 人工知能(AI)。知的な働きに関わる課題を処理するシステムの総称。
- 機械学習。個々の場合のルールをすべて人が書く代わりに、データからパターンを学ぶ方法。
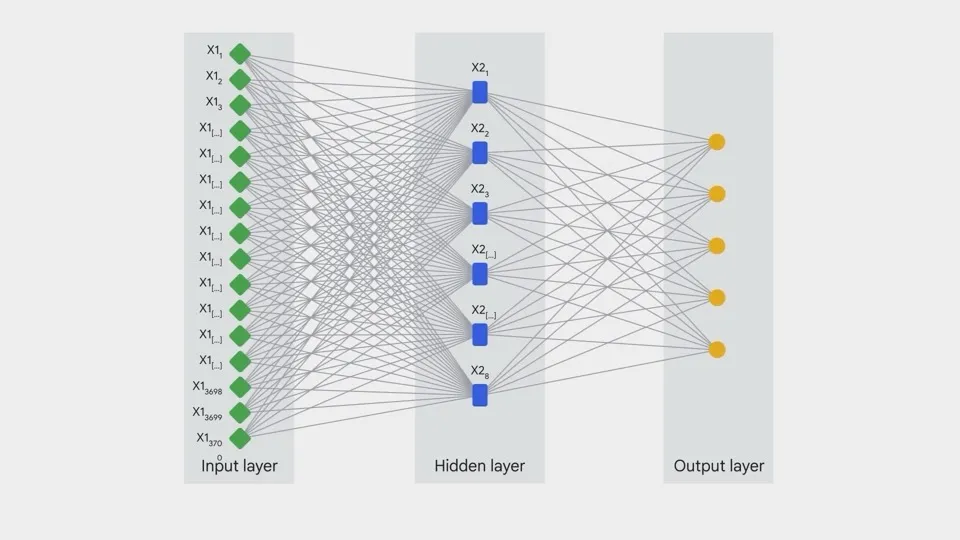
- 深層学習。多くの層を重ねたニューラルネットワークで、複雑なパターンを表現する機械学習。
学習には、ラベル付きの例、データそのものから取り出した構造、行動へのフィードバックなどを使える。現在の生成AIの多くは、こうした方法の一つ以上を 深層学習 と組み合わせて使う。
教師あり学習と教師なし学習
何を手がかりに学ぶのか
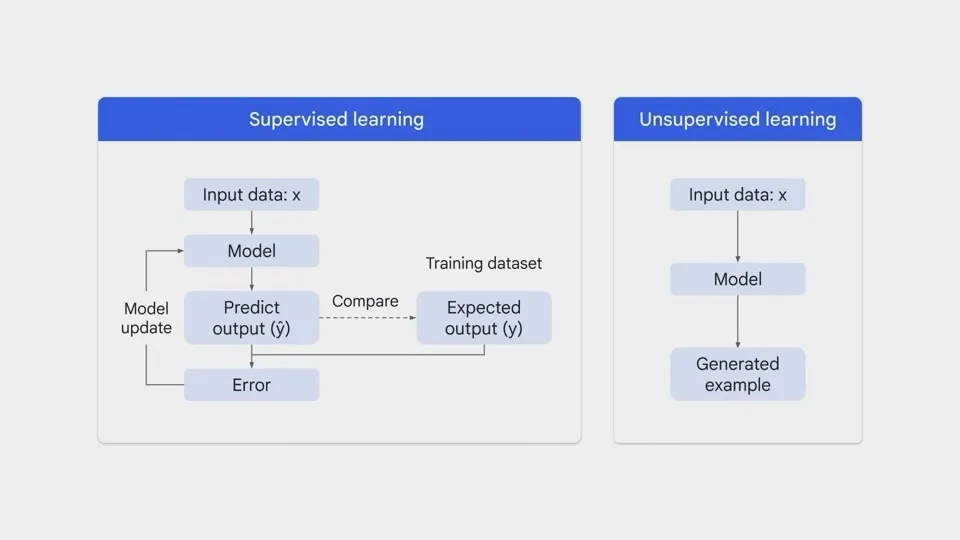
モデルはデータからパターンを学ぶ。違うのは、 学習時にどのような情報が与えられるかだ。ラベルや予測すべき値、フィードバックによって、モデルが何を上達させるかが決まる。
教師あり学習
教師あり学習では、訓練データに 正解となる出力を添えた例が含まれる。 ラベル は、画像に写る物の名前、メールが迷惑メールかどうか、予測させたい数値などだ。
十分な例があれば、モデルは新しい入力にも使える関係を学ぶ。
この入力には、この出力が対応する。 学習時には、予測と正解を比べてモデルを調整する。推論時には、新しい例に学んだことを適用する。
身近な課題にも当てはまる。
- 迷惑メールと通常のメールの例 → 迷惑メールフィルター
- 成約価格と広さや立地の情報 → 住宅価格の推定
- 猫や犬の名前を付けた画像 → 画像の分類
代表的な課題は、カテゴリを選ぶ 分類と、数値を推定する 回帰だ。 信頼できるラベルをそろえる には、時間や費用がかかることがある。精度は例の質と、どこまで幅広い事例を網羅できるかにも左右される。
教師なし学習
この場合は、データに 教師あり学習で使う正解ラベルが付いていない。モデルは、 データの中にある構造を探す。繰り返し現れるパターンや、似た特徴を持つまとまりがその例だ。
典型的には、データの構造について次のような問いを立てる。
- データはどんなグループに分かれるか。
- 似ている事例にはどんな共通点があるか。
- ほかの事例に比べて何が異例か。
用途には、たとえば次のようなものがある。
- クラスタリング で共通の特徴を持つ記録をまとめる。
- 購買パターンから顧客をグループ分けする。
- 取引やネットワーク上の異常な動きを探す。
人がラベルを付けようとも思わなかった関係を見つけられることがある。 その関係が何を意味するのか 、実際に役立つのかは別途検討する。
二つを分けて考える理由
モデルが何を学んだかを問う前に、 学習時に何を正解として与えたか を考える。
- 教師あり学習は、 訓練用の例に正解を用意できる場合に向く。
- 教師なし学習は、 見つけたい構造にまだラベルが付いていない場合に役立つことがある。
言語モデルの事前学習では、 自己教師あり学習がよく使われる。次のトークンを予測するように、予測すべきものをテキスト自体から取り出す。その後、 人が書いた回答例やフィードバック で、モデルの応答の仕方を調整することもある。
生成モデルと識別モデル
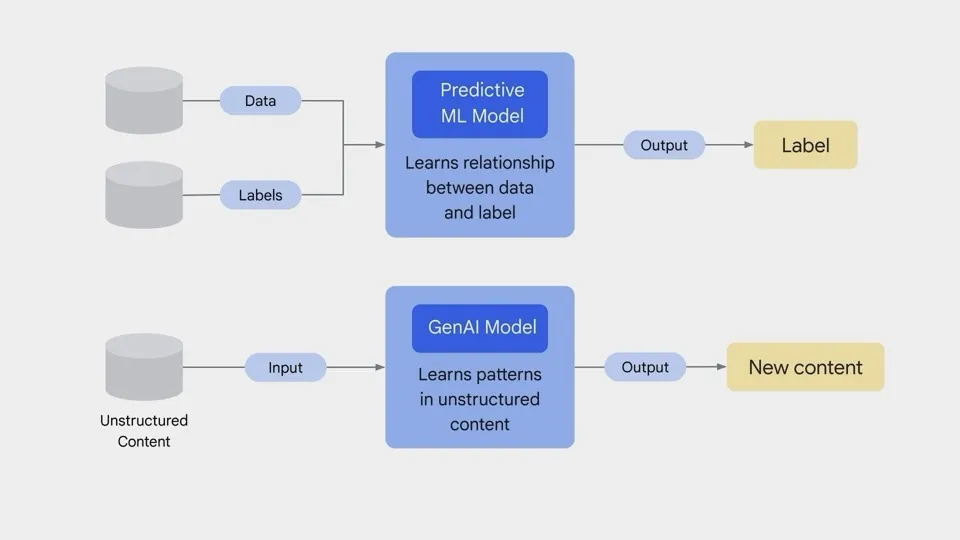
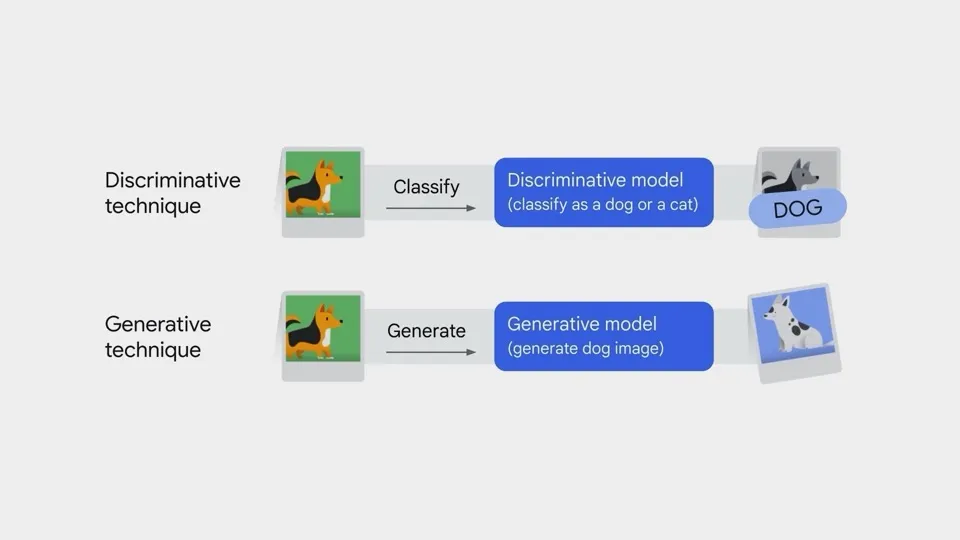
講座は、入力を見て判定するモデルと、新しい例を出力できるモデルも区別する。
- 識別モデルは、メールを迷惑メールと判定したり、画像に猫が写っていると分類したりすることを学べる。
- 生成モデルは、学習方法や使い方に応じて、文章、画像、合成音声などを作る。
簡単に言えば、識別モデルは与えられた入力について判定や予測をする方法を学ぶ。生成モデルは、新しいものを出力するために、 サンプリングの元になるパターンや分布 を学ぶ。
言語モデルのTransformer
現代の言語モデルの多くは、 Transformerを土台にしている。 2017年に発表された論文では、注意機構を使い、トークン同士の関係を扱う構造が示された。
元のモデルでは、ある系列を別の系列に変換するために エンコーダーとデコーダー を使った。文章を生成するモデルの多くはデコーダーだけを使う。学習時は複数の位置をまとめて処理できるが、生成時は通常、新しいトークンを順に一つずつ出す。
もっともらしい回答に、実在しない情報や誤った主張が混じることがある。 ハルシネーションと呼ばれる現象だ。もっともらしい言葉の並びを作れることと、記述が事実であることは別だ。重要な事実は確認できる資料に当たる。
プロンプト、出力、ツール
モデルが答えを作るとき、どのような入力を渡すかで結果が変わる。
プロンプトには、質問、使ってほしい資料、出力形式の例、守るべき制約などを入れられる。その指示をどのように組み立てるかを考える作業は、プロンプトエンジニアリングと呼ばれる。
講座では代表的な用途をいくつか取り上げる。
- テキスト → テキスト
- テキスト → 画像
- テキスト → 動画や3Dコンテンツ(対応するモデルを使用)
- テキスト → 操作や作業の実行(適切なツールに接続したシステムを使用)
基盤モデルは複数の用途に使ったり適応させたりできるよう、幅広く学習させたモデルだ。利用者が触れる製品は、その上にツールや情報検索、画面上のルールを加えることができる。
講座に登場するGoogleのツール
最後に、講座はGoogle Cloudのツールを紹介する。
当時のGoogle Cloudのサービスとして紹介されるのは、 Vertex AIとModel Garden だ。開発者はカタログからモデルを選び、そのまま使ったり、用途に合わせたりできる。製品名や提供内容は変わるため、現在使えるものは公式ドキュメントで確かめたい。
PaLM APIとMakerSuiteは、以前の世代の開発者向けツールだ。 Google AI StudioとGemini API を参照すると、現行の利用例を確認できる。Geminiのモデルごとに機能が違うので、必要な入出力形式が使えるかはドキュメントで確認する。
短い講座を終えて持ち帰れること
この講座は、 システムに何ができるか、 どんな場面で使うか 、そして 主な考え方がどうつながるかを短い時間で説明する。
名前はよく聞くけれど、どの部分が何を担うのかわからないときの入り口になる。モデルがラベルを予測し、原稿を作り、あるいは事実を取り違えたとき、何が起きたかを考える言葉も手に入る。
もう少し長い講座に進んだり、自分でモデルを試したりする前に、 例から学ぶ段階と、応答を生成する段階の違い をここで整理しておきたい。
講座情報
Introduction to Generative AI
- 分野
- コンピューターサイエンス・人工知能
この記事のアフィリエイトリンクを通じて購入すると、OWL Magazineが手数料を受け取る場合があります。